Conector de Origem para Databricks
Este guia descreve como configurar o digna para se conectar ao Databricks via ODBC, usando uma connection string sem DSN.
O lado do digna na configuração é o mesmo para todas as tecnologias — onde as conexões são criadas, como os valores das propriedades são criptografados, como uma conexão é testada e o que significam os modos de perfilamento. Isso está descrito na Visão Geral das Conexões de Banco de Dados. Esta página cobre o que é específico do Databricks.
O Unity Catalog é obrigatório
O digna lê os catálogos disponíveis em system.information_schema.catalogs, portanto o workspace deve ter o Unity Catalog habilitado. Releases anteriores do digna ofereciam uma tecnologia separada, "Databricks Legacy", para workspaces sem Unity Catalog; ela não está mais disponível.
1. Instalar o Driver ODBC
Instale o Databricks ODBC Driver na máquina que executa o backend do digna, seguindo o guia de instalação do Databricks.
Dependendo da versão, o driver se registra como Simba Spark ODBC Driver ou como Databricks ODBC Driver. Leia no seu host o nome exato registrado, conforme descrito em Instalar o Driver ODBC no Host do digna.
2. Reunir os Detalhes da Conexão
Todos os valores vêm do SQL warehouse (ou cluster) que você quer que o digna use. Abra-o no workspace do Databricks e vá para Connection details:
| Campo do Databricks | Usado como |
|---|---|
| Server hostname | Host |
| Port | Port, normalmente 443 |
| HTTP path | HTTPPath |
Para a autenticação, crie um personal access token — veja Autenticação com personal access token do Databricks. Os tokens pertencem a um usuário ou service principal, e esse principal precisa de USE CATALOG, USE SCHEMA e SELECT nos dados de origem.
3. Propriedades ODBC
Um exemplo, não uma especificação
O conjunto abaixo é uma combinação que comprovadamente funciona. As propriedades pertencem ao driver Databricks/Simba, portanto seus nomes, valores padrão e valores aceitos variam entre versões do driver — o driver foi renomeado e suas opções de autenticação foram ampliadas mais de uma vez — e entre plataformas. Use isto como ponto de partida e consulte a documentação da versão do driver que você instalou.
Adicione as seguintes propriedades na tela Add DB Connection:
| Key | Valor de exemplo | Observações |
|---|---|---|
Driver | Simba Spark ODBC Driver | Deve corresponder ao nome do driver registrado no host do digna |
Host | <workspace>.cloud.databricks.com | Server hostname do warehouse, ex.: adb-1234567890123456.12.azuredatabricks.net |
Port | 443 | |
HTTPPath | /sql/1.0/warehouses/<warehouse-id> | HTTP path do warehouse ou cluster |
SSL | 1 | Os endpoints do Databricks aceitam apenas TLS |
ThriftTransport | 2 | Transporte HTTP, que é o que os endpoints SQL usam |
AuthMech | 3 | Autenticação por token |
UID | token | A palavra literal token, não um nome de usuário |
PWD | dapi… | O personal access token. Marque Encrypted |
UseNativeQuery | 1 | Repassa o SQL do digna sem alterações — veja abaixo |
A connection string resultante fica assim:
Driver=Simba Spark ODBC Driver;Host=<workspace>.cloud.databricks.com;Port=443;HTTPPath=/sql/1.0/warehouses/<warehouse-id>;SSL=1;ThriftTransport=2;AuthMech=3;UID=token;PWD=dapi…;UseNativeQuery=1
Mantenha UseNativeQuery=1
Com UseNativeQuery=0 — o padrão do driver —, o driver reescreve o SQL recebido no que ele considera sintaxe ODBC portável. O digna já gera SQL do Databricks, então a reescrita pode alterar a citação com crases e os literais de data, e o perfilamento passa a falhar em instruções que são válidas como foram escritas.
OAuth em Vez de um Token
Para um service principal com autenticação OAuth máquina a máquina, substitua AuthMech, UID e PWD por:
| Key | Valor de exemplo | Observações |
|---|---|---|
AuthMech | 11 | OAuth |
Auth_Flow | 1 | Client credentials |
Auth_Client_ID | <application id> | Service principal |
Auth_Client_Secret | <client secret> | Marque Encrypted |
4. Configuração do digna
Na tela Add DB Connection, informe o seguinte:
Name:               Name of the connection. This is used for referencing the connection in other screens.
Technology:         Databricks
Profiling Mode:     Standard, Permanent or Session
Work Schema:        Schema for the work tables of "Permanent" profiling, e.g. "digna_work"
5. Observações sobre o Databricks
- O warehouse deve estar em execução, ou poder ser iniciado, quando o digna se conecta. Um warehouse que é retomado a partir do estado parado pode demorar mais do que o timeout de conexão — se o teste falhar na primeira tentativa após um período de inatividade, tente novamente.
- Os catálogos vêm do workspace. Ao contrário da maioria das tecnologias, uma conexão do Databricks alcança todos os catálogos que o principal tem permissão para ver, então uma única conexão pode atender a origens em vários catálogos.
- Modos de perfilamento. Permanent cria as tabelas de trabalho em Work Schema dentro do catálogo da origem, então o principal precisa de
CREATE TABLEali. Session usaCREATE TEMPORARY TABLEe não utiliza Work Schema. Standard precisa apenas de acesso de leitura. - Warehouses serverless funcionam da mesma forma; apenas o
HTTPPathmuda.
6. Verificar o Driver (opcional)
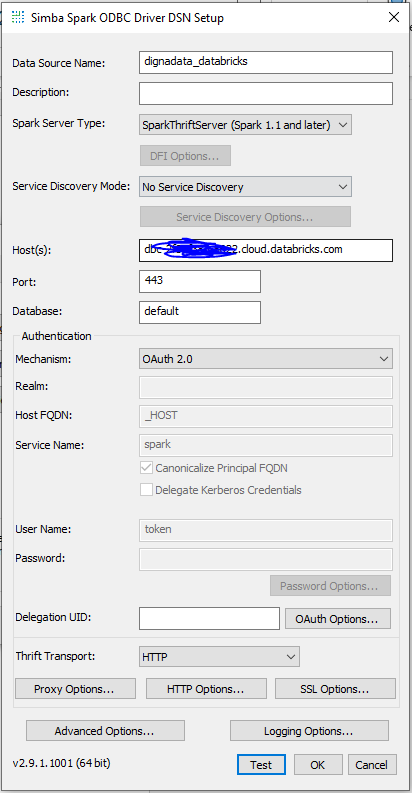
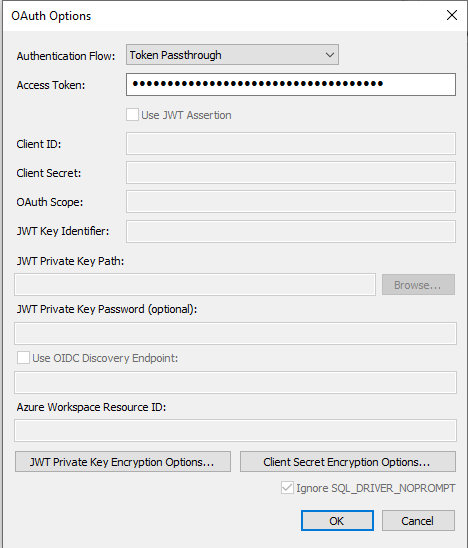
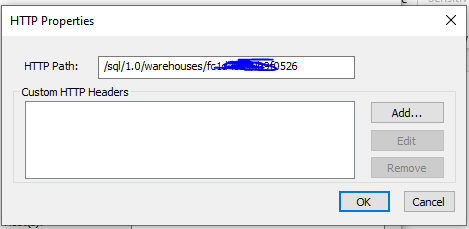
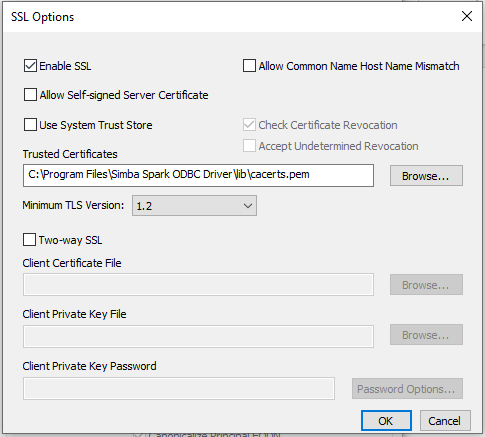
Configurar uma fonte de dados ODBC não é necessário para uma conexão sem DSN, mas o diálogo do próprio driver é uma forma prática de confirmar que o driver, o warehouse e o token funcionam antes de inseri-los no digna.
Passo 1
Passo 2
Passo 3
Passo 4
Passo 5 – Testar a Conexão
Clique no botão TEST. Uma conexão bem-sucedida deve ter esta aparência:
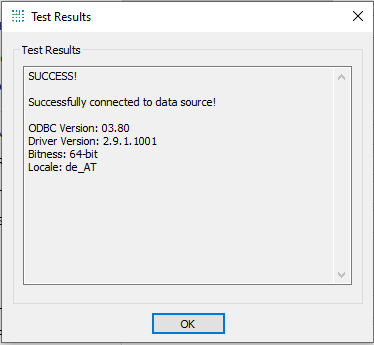
O host, o HTTP path e o token inseridos aqui são exatamente os valores que as propriedades da seção 3 recebem.